Corriger ou atténuer: le CRA ne prévoit que deux réponses
Depuis le 11 septembre 2026, le délai de déclaration du Cyber Resilience Act (CRA) se prépare dans la chaîne de livraison, pas dans la cellule de crise
Imaginons le scénario suivant: vendredi soir, une vulnérabilité activement exploitée est signalée dans une bibliothèque que tout le monde embarque. Le compteur de 24h démarre dès que l’éditeur sait que cette faille touche son produit.
Deux questions se posent alors:
Dans quels produits, dans quelles versions, chez quels clients?
Peut-on couper la fonctionnalité exposée ce soir, sans développeur, sur une version livrée il y a trois ans?
Si la réponse à la première question demande deux jours d’enquête, le délai est déjà compromis. Si la réponse à la seconde question est non, il faudra informer les clients qu’ils vont rester exposés pendant un certain temps.
Je le dis d’emblée: le délai de 24h ne se tient pas au moment de l’incident. Il se prépare dans la chaîne de livraison, dans le nombre de versions qu’on accepte de maintenir, dans la capacité des produits à être atténués sans développeur, et dans la décision de mettre ou non un produit sur le marché européen.
Ce qu’exige le 11 septembre, en bref
Depuis le 11 septembre 2026, les fabricants de produits comportant des éléments numériques déclarent les vulnérabilités activement exploitées et les incidents graves ayant des répercussions sur la sécurité du produit.
Un éditeur est fabricant dès qu’il met un logiciel, payant ou gratuit, sur le marché sous son nom ou sa marque, dans le cadre d’une activité commerciale. Les produits déjà mis sur le marché sont aussi couverts, parc existant compris.
Une exploitation connue avant le 11 septembre n’a pas à être déclarée après coup; celle qui est découverte depuis cette date se déclare, même sur une faille ancienne. Une faille dans une bibliothèque intégrée au produit est une faille du produit, et c’est à l’éditeur de la déclarer.
Pour la Commission, cette déclaration ne s’impose que si la faille est exploitée dans le produit de l’éditeur: présente mais inatteignable, ou exploitée seulement ailleurs, elle ne déclenche pas son délai.
Une vulnérabilité est activement exploitée lorsqu’il existe des preuves fiables qu’un acteur malveillant l’a exploitée sur un système sans l’autorisation de son propriétaire. En revanche, découverte avant toute exploitation, elle n’a pas à être déclarée, corrigée ou non.
Un incident est grave dès qu’il remplit l’un des deux critères, qualitatifs et sans seuil chiffré: qu’il entache ou soit susceptible d’entacher la capacité du produit à protéger la disponibilité, l’authenticité, l’intégrité ou la confidentialité de données ou fonctions sensibles ou importantes; ou qu’il ait conduit ou soit susceptible de conduire à l’introduction ou à l’exécution d’un code malveillant dans le produit, ou dans le réseau et les systèmes d’information d’un utilisateur.
La déclaration part simultanément vers le CSIRT coordinateur du fabricant, l’équipe nationale de réponse aux incidents de sécurité, et vers l’ENISA, par la plateforme unique de signalement, et non vers le public: alerte précoce sans retard injustifié et au plus tard à 24h, notification au plus tard à 72h, puis un rapport final.
Pour une vulnérabilité, ce rapport est dû au plus tard 14 jours après la mise à disposition d’une mesure corrective ou d’atténuation; pour un incident grave, au plus tard un mois après la notification des 72h.
Atténuer, c’est fermer le chemin d’exploitation ou limiter ce que l’attaquant en tire, sans supprimer la faille. Informer les utilisateurs concernés est une obligation distincte.
Les obligations du 11 septembre ne fixent aucun délai pour corriger. Elles imposent de le dire, et une mesure d’atténuation suffit à faire partir le rapport final.
Premier tri: le code de l’éditeur, ou celui d’un autre?
Tout commence par ce tri. Il décide de ce que l’éditeur pourra écrire à 72h.
Quand la faille exploitée est dans son propre code, qu’elle ait été localisée par l’analyse statique du code (SAST), par les tests dynamiques (DAST) ou signalée par quelqu'un, l’éditeur a la main. La question devient arithmétique: combien de versions maintenues faut-il corriger, et chacune peut-elle passer en production vite?
Quand la faille vient d’une dépendance tierce, à condition que celle-ci soit toujours maintenue, l’éditeur dépend du calendrier du mainteneur alors que ses délais courent déjà. Rien ne les suspend: ni le week-end, ni l’attente d’un correctif amont. Et la déclaration lui revient.
J’ai mesuré une fois ce que vaut la disponibilité d’un mainteneur bénévole. Un bug grave découvert dans une bibliothèque open source, une pull request complète portant l’intégralité de la solution, acceptée deux mois plus tard avec ce message: je travaille gratuitement, c’est un projet open source, tu me paies, je corrige plus vite. Il avait raison. Mais deux mois, ce sont deux mois de clients exposés, et une notification des 72h sans mesure à annoncer.
Le pire des cas reste celui où la dépendance n’est pas maintenue. La déclaration revient quand même à l’éditeur, et personne en amont ne produira le correctif. La question se pose frontalement: faut-il modifier soi-même la bibliothèque? Les options sont connues, et toutes coûteuses:
La corriger soi-même, par un fork ou un patch interne
Remplacer la dépendance
Retirer ou désactiver la fonctionnalité qui l’utilise
Le fork a un coût caché. L’éditeur devient mainteneur de ce composant, sur toutes les versions du parc qui l’embarquent, pour toute leur durée de vie, y compris pour les failles suivantes. Et il faudra peut-être un jour le resynchroniser avec le dépôt distant, ce qui devient plus difficile à chaque divergence.
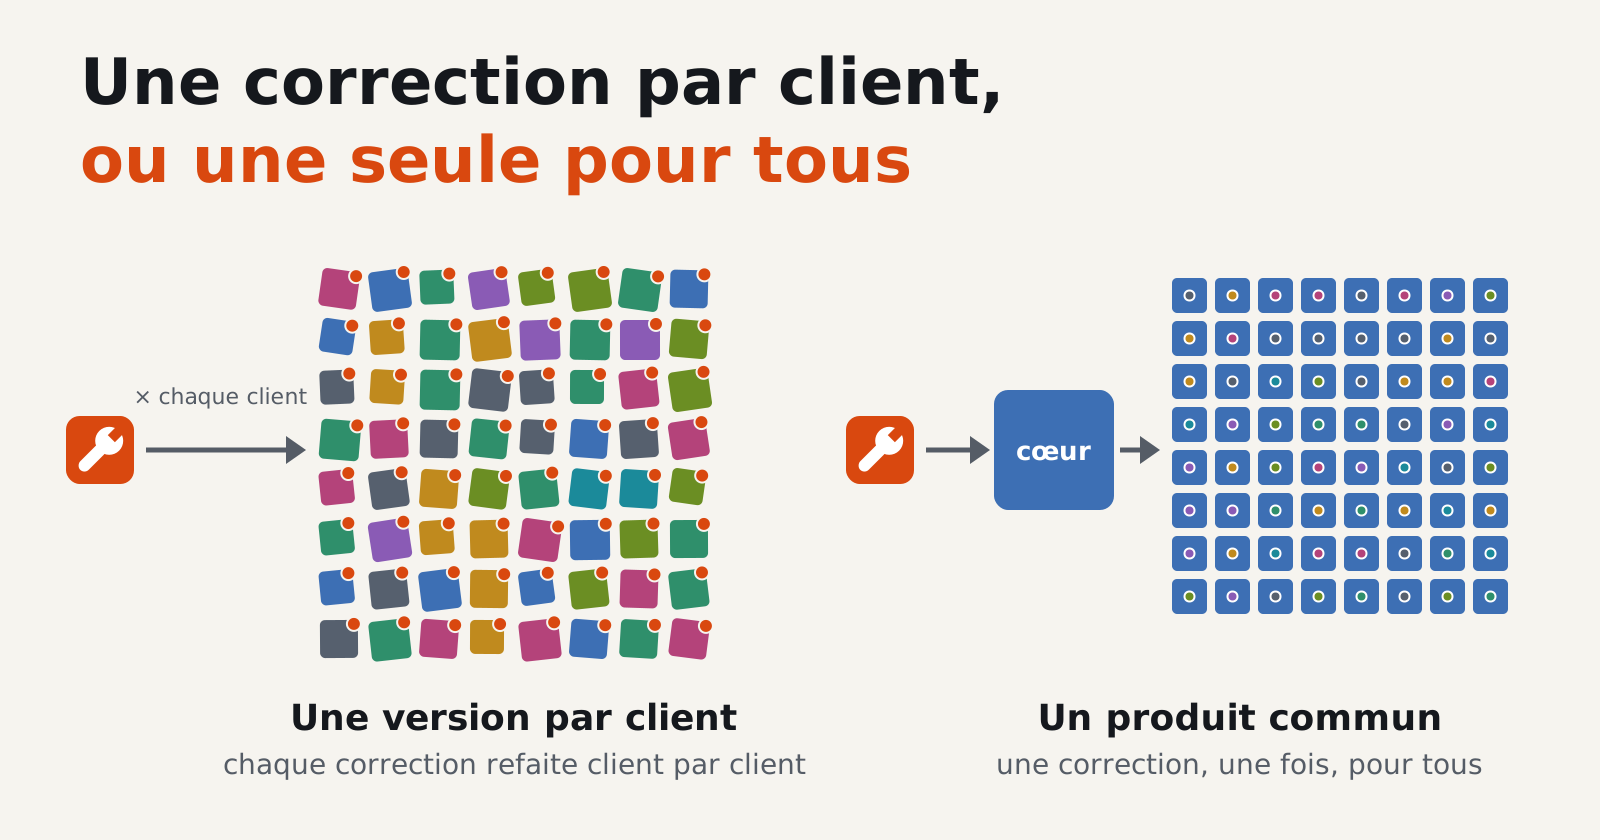
L’éditeur n’est pas seul dans ce cas. Tous ceux qui embarquent cette bibliothèque abandonnée ont la même faille. Le délai court pour chacun dès qu’elle est exploitée dans son produit, et chacun produit son correctif dans son coin, sans coordination: plusieurs forks divergents d’un même composant, autant de corrections à revalider, et aucune version de référence. Une dépendance abandonnée transforme une faille unique en N corrections parallèles, chez chacun d’eux. Les attitudes possibles, dont aucune n’est une obligation du 11 septembre:
Reverser le correctif en amont, quand le dépôt existe encore, même sans mainteneur actif
Le partager ouvertement, pour que les autres utilisateurs n’aient pas à le refaire
Porter seul un fork qui diverge de ceux des autres
Je recommande de reverser le correctif quand le dépôt vit encore, et sinon de le partager ouvertement: ces deux attitudes sont les moins coûteuses collectivement, et les seules qui réduisent le travail total. La troisième, on la subit.
Par ailleurs, si le produit permet une atténuation, l’éditeur la met à disposition et la déploie lui-même là où il exploite le produit. Sur un produit conçu avant le CRA, souvent, rien ne le permet: la fonctionnalité exposée ne peut être ni désactivée, ni isolée, ni contournée sans casser le produit. Une parade existe parfois hors du produit: une règle de pare-feu applicatif, un filtrage au reverse proxy, un isolement réseau, etc. Elle dépend alors de l’infrastructure, mais l’éditeur doit savoir comment la mettre en œuvre dans l’environnement de déploiement. À défaut, il reste le correctif amont ou le correctif interne, sans filet. Et à 72 h, il faut écrire ce que les utilisateurs peuvent faire ou non.
En ce qui concerne le correctif, son effet est multiplicateur à l’échelle d’un parc de produits. Une vulnérabilité exploitée dans une dépendance n’est presque jamais à un seul endroit du parc. Elle est dans plusieurs produits, et dans plusieurs versions de la même dépendance. Une seule faille, ce sont N correctifs à produire, à tester et à livrer, et un rapport final qui ne peut partir qu’une fois la mesure disponible. C’est là que l’inventaire cesse d’être de la documentation et devient la condition nécessaire pour tenir le délai.
Puisque la déclaration revient tout de même à l’éditeur, c’est à lui d’engager dès maintenant le travail d’inventaire, de sa propre initiative (Ce n’est pas une obligation du 11 septembre, mais cela relève du bon sens):
Lister d’abord toutes les dépendances du parc, par produit et par version maintenue
Repérer ensuite celles qui sont à risque:
Les obsolètes (versions en fin de vie ou en retard important sur la dernière version)
Les non maintenues (projet archivé, aucune version depuis longtemps, failles passées jamais corrigées)
Les peu actives (un seul mainteneur, peu de contributions, questions et signalements sans réponse)
Pour un tiers commercial, négocier aussi ses engagements de correction et de notification
Préparer le plan B de chacune, avant l’incident: la dépendance de remplacement identifiée, ou le fork assumé avec son responsable nommé, ou le contrat qui engage un tiers à corriger, ou la fonctionnalité qu’on sait couper.
Un plan B choisi à froid se déclenche le vendredi soir. Un plan B improvisé le vendredi soir n’existe pas.
Ce qui doit exister avant l’incident
Rien de ce qui précède ne tient sans une chaîne de livraison en état. Aucune des pratiques d’ingénierie qui suivent n’est une obligation du 11 septembre, mais elles rendent l’obligation tenable:
Un pipeline capable à tout moment de reconstruire, corriger, tester et livrer chaque version maintenue, que la faille vienne du code de l’éditeur ou d’une dépendance
Des versions reconstructibles: toolchain, images de base et dépendances conservées et figées, dans un environnement isolé du reste du système d’information. Une version qu’on ne sait plus reconstruire est une version qu’on ne sait plus corriger
Un SBOM, la nomenclature des composants logiciels, produit à chaque build, versionné, relié à l’artefact livré et aux clients
La capacité d’interroger le parc en minutes, pas en jours: quel produit, quelle version, contient ce composant?
Pour chaque version, un avis d’exploitabilité (VEX) qui dit si le code vulnérable est réellement atteignable. Un composant présent n’est pas toujours exploitable, et cet avis est l’un des éléments qui étayent, le jour venu, la décision de déclarer ou non
Une mise à jour des dépendances vulnérables proposée automatiquement dans les pipelines, tirée d’un dépôt interne qui en vérifie la provenance, et validée par les tests de chaque version
La chaîne de build et le canal de mise à jour protégés comme le produit lui-même: une intrusion qui peut y injecter du code malveillant est un candidat sérieux à l’incident grave
La trace de chaque signalement reçu et de son évaluation initiale, menée sans attendre: pour la Commission, le compteur part dès que cette évaluation établit, avec une certitude raisonnable, que la faille est exploitée dans le produit
Réduire le nombre de versions maintenues, et décider avant de vendre
Chaque version maintenue est un pipeline à tenir en état, un SBOM à suivre, un correctif de plus et un dossier de déclaration plus lourd à chaque faille.
Pour moi, réduire ce nombre devient indispensable, et cela demande un nouveau modèle de support: deux versions maintenues au plus, la dernière et la précédente, une fin de support écrite au contrat, et une montée de version offerte au client. Elle coûte moins cher qu’une version de plus à maintenir, tant qu’elle n’impose au client ni nouveau matériel ni nouvelle infrastructure. La fin de support arrête les correctifs; l’obligation de déclarer, elle, continue. Une version hors support mais exploitée chez un client reste à déclarer, et la mesure à lui proposer est le plus souvent la montée de version.
Le raisonnement va jusqu’au bout. Chaque produit mis sur le marché européen et couvert par le règlement entre dans ce dispositif de déclaration, avec tout ce qu’il suppose: pipeline, inventaire, astreinte, capacité d’atténuation. À mes yeux, un composant ou un produit dont le coût dépasserait ce qu’il rapporte ne doit tout simplement pas être mis sur le marché européen. La décision se prend en amont, avant sa première mise à disposition en Europe, payante ou gratuite, dans un cadre commercial: après, le produit est déjà couvert. Le responsable produit doit pouvoir l’instruire, chiffres à l’appui, avec le RSSI, puis la direction arbitre.
La capacité d’atténuation se conçoit, elle ne s’improvise pas
Les produits legacy montrent ce qu’il faut désormais concevoir. L’enjeu reste dans le périmètre du 11 septembre: être capable de mettre à disposition une mesure d’atténuation à déclarer à 72h, et faire démarrer le rapport final sans attendre le mainteneur d’un tiers.
Aucune obligation du 11 septembre n’impose ce qui suit. Je le fais porter aux nouveaux produits comme critères d’acceptation de conception, au même titre qu’une exigence fonctionnelle:
Chaque fonctionnalité exposée à une entrée non maîtrisée, repérée par l’analyse de menace, peut être désactivée, isolée ou restreinte par configuration, sans nouvelle livraison, avec un mode dégradé défini
L’interrupteur est testé dans le pipeline à chaque version: un interrupteur jamais actionné ne marchera pas le vendredi soir
L’interrupteur est traité comme la surface d’attaque qu’il est: accès restreint, authentifié, tracé, configuration signée; il retire une fonctionnalité, il n’affaiblit jamais un contrôle de sécurité
Les dépendances critiques sont isolées derrière une interface qui permet de les remplacer ou de les couper
Chaque fonctionnalité a sa fiche d’atténuation, rédigée à froid: comment la couper, qui décide de la couper, qui la coupe, quel impact pour l’utilisateur, quel message lui envoyer et qui l’envoie.
Cela suit précisément la même logique qu’un PCA/PRA ou du chaos engineering: rédigé à froid et testé régulièrement.
Couper la fonctionnalité exposée est souvent la seule mesure disponible. C’est un mal nécessaire, et c’est exactement ce qu’il faut écrire aux clients. Encore faut-il que ce soit possible. Sur un produit qui n’a pas été conçu pour, il n’y a rien à couper sans le casser: l’atténuation reste théoriquement possible et pratiquement indisponible, faute d’avoir été prévue dans les versions déjà déployées chez les clients. C’est ce travail de conception qui transforme le «rien à faire qu’attendre» du legacy en une atténuation déployable en quelques heures.
Le vendredi soir, sans maintenance 7 jours sur 7
Les délais courent à partir de la prise de connaissance, week-end compris. Beaucoup d’organisations n’ont pourtant aucune équipe de développement disponible le samedi. Trois capacités se distinguent, et les confondre coûte cher.
L’alerte à 24h demande une personne habilitée à déclarer, avec une délégation écrite et un modèle prêt. Elle ne demande pas une équipe de développement.
L’atténuation demande de pouvoir déclencher l’interrupteur sans développeur et sans livraison. Sur la partie du produit que l’éditeur héberge lui-même, son équipe d’exploitation l’actionne. Sur un produit installé chez le client, c’est le client qui l’actionne: l’atténuation devient une procédure documentée qu’il applique, et que portent la notification des 72h et l’information des utilisateurs.
Le contrat le prévoit avant l’incident: le droit de couper une fonctionnalité pour des raisons de sécurité, et un contact sécurité chez le client, qui remonte les exploitations qu’il constate.
Le correctif, lui, revient en heures ouvrées, sans mettre les développeurs en astreinte, à une condition: que l’atténuation ait été déployée le vendredi, ou mise à la disposition des clients qui exploitent eux-mêmes le produit. Les obligations du 11 septembre ne lui fixent aucun délai. Le mode dégradé imposé aux clients en fixe un.
Sans atténuation possible, il reste deux issues: mobiliser des développeurs le week-end, ce qui suppose une astreinte organisée et payée, ou écrire dans la notification des 72h que les clients restent exposés. Le choix entre les deux se fait à froid, produit par produit, et la direction le signe. Ce coût-là entre dans le calcul de rentabilité évoqué plus haut.
Qui lit ce que vous déclarez
Les alertes et les notifications ne sont pas publiques. Elles circulent entre le CSIRT coordinateur qui les reçoit, les CSIRT des États membres où le produit est disponible, l’ENISA et les autorités de surveillance du marché.
Dans des circonstances exceptionnelles, le fabricant peut indiquer le degré de sensibilité qu’il attribue à l’information et demander que sa diffusion aux autres CSIRT soit retardée. C’est le CSIRT qui décide de ce report; il reste limité à ce qui est strictement nécessaire et ne suspend aucun délai.
Il faut rester lucide sur ce qui finit par sortir: un document fuit, une information circule. Mais une vulnérabilité activement exploitée est déjà entre les mains d’au moins un attaquant. La déclaration ne lui apprend rien; le report de diffusion sert aussi à ne pas l’apprendre aux autres. Le silence, lui, laisse le client sans défense.
Ce qui sort vraiment du cercle des autorités, c’est l’information des utilisateurs. Elle est obligatoire: le fabricant informe les utilisateurs touchés, ou tous s’il y a lieu, de la vulnérabilité ou de l’incident et des mesures qu’ils peuvent prendre. Elle lui échappe s’il tarde: les CSIRT peuvent la délivrer à sa place quand ils l’estiment nécessaire.
Un éditeur qui peut annoncer une atténuation efficace sous 72h, par un interrupteur ou une consigne aux utilisateurs, peut aussi plaider pour que la diffusion entre CSIRT attende. La décision reste au CSIRT, et la diffusion suit si l’atténuation n’arrive pas à temps. Le kill switch protège deux fois: il protège les clients, et il change ce que la notification et l’information des utilisateurs ont à dire.
Gouvernance: ce qui se décide à froid
Trois décisions et un exercice se préparent à froid. Le RSSI, ou le PSIRT, l’équipe de réponse aux incidents de sécurité des produits, là où elle existe, instruit ces décisions; la direction les tranche et signe la délégation.
Qui décide de déclarer, auprès de quel CSIRT, sur quels critères, avec quelle délégation.
L’arbitrage entre sous-déclaration et sur-déclaration: déclarer trop produit du bruit et abîme la crédibilité, déclarer trop peu laisse les clients sans défense. Chaque décision de ne pas déclarer laisse une trace écrite et motivée.
La politique des dépendances: qui tient l’inventaire des dépendances à risque, à quelle fréquence il est revu, qui décide de déclencher un plan B, fork, remplacement ou coupure.
Un exercice à blanc, chronométré, sur un vrai produit legacy embarquant une dépendance tierce, avec le déclarant, le support, celui qui écrit aux clients et un client qui exploite lui-même le produit. C’est le seul moyen de savoir si l’alerte, l’atténuation et le correctif tiennent avant d’en avoir besoin.
Mes règles d’or
Ces règles n’engagent que moi. Je les pose, je les applique, et je les publie pour qu’elles soient reprises. Aucune n’est une obligation du 11 septembre, et chacune s’appuie sur des pratiques connues du métier. Ce qui m’appartient, c’est d’en faire des règles: elles sont la réponse logique à ce que le 11 septembre 2026 rend inévitable.
L’inventaire est intégral: Toute version livrée et encore en service chez un client y figure, maintenue ou non, avec ses composants et ses dépendances, par produit et par client.
La R&D produit et valide la composition de chaque version: Le support, ou l’exploitation, tient à jour la version installée chez chaque client. Le RSSI reçoit cet inventaire. Reconstituer le parc pendant le compteur de 24 h ne relève pas du RSSI. L’inventaire est fourni, daté, validé par ceux qui construisent ou maintiennent les produits.
Le SBOM est la source: Il est produit à chaque build et relié à l’artefact livré, pour chaque version maintenue.
L’analyse de sécurité est obligatoire: SAST, DAST et analyse de composition couvrent tous les composants, images de conteneur et couches de base comprises. Une faille dans l’image de base livrée est une faille du produit livré: activement exploitée, elle se déclare au même titre.
La réactivité est continue: Une analyse de composition et de dépendances tourne en permanence sur chaque version maintenue, pas seulement sur la dernière, et se croise avec les signaux d’exploitation publiés. L’alerte arrive avant le signalement extérieur.
La branche principale est la plus propre possible: C’est la seule façon de ne pas ajouter sa dette au traitement de l’incident, et c’est depuis elle que se produisent les correctifs à rétroporter.
Le pipeline CI/CD est la chaîne de preuve: Aucun artefact livré ne contourne le pipeline de construction, de contrôle et de traçabilité défini par le produit. Le code source, les dépendances, les contrôles de sécurité et l’artefact produit sont reliés entre eux. Ce qui est construit ou modifié hors chaîne ne peut pas devenir une version livrée.
Une dernière règle les tient toutes: Aucune version maintenue, aucun composant n’échappe aux précédentes. Toute exception est écrite, datée, limitée dans le temps et signée par la direction.
Ce que l’horloge révèle
Le problème est antérieur au CRA. La chaîne de livraison, la conception des produits et la gestion du portefeuille auraient dû le résoudre depuis longtemps. Le règlement y pose une horloge, et une horloge ne se négocie pas. Le 11 décembre 2027, l’essentiel du texte s’appliquera à ce qui sera mis sur le marché à partir de cette date, et une partie de ces règles d’or deviendra une exigence. L’horloge tournera alors depuis plus d’un an, et elle aura déjà désigné les meilleurs: ceux qui savent construire des produits.
Sources
Cyber Resilience Act — Reporting obligations, Commission européenne
Lignes directrices sur l’application du CRA, C(2026) 5252, Commission européenne, non contraignantes
Questions fréquentes sur la plateforme unique de signalement, ENISA, documentation opérationnelle
N.B.: Cet article présente mon analyse des implications du règlement, appuyée sur son texte et sur les lignes directrices publiées par la Commission. Il ne constitue pas un avis juridique et ne remplace pas celui d’un juriste ou d’un avocat sur la situation de votre organisation. Mon objectif est de proposer une feuille de route et mes règles d’or, là où la stratégie rejoint l’architecture.
About the author
- Stratégie · Transformation · Ingénierie · Architecture
Comments
Join the discussionNo comments yet. Be the first to comment.